Em 5 de outubro de 2026, um dia depois do primeiro turno, criei dois repositórios: o Mapa do voto · Paraíba e o Mapa do voto · Bayeux. Dois sites públicos, com votos de presidente a vereador (presidente na Paraíba, vereador em Bayeux), histórico de eleições desde 2012, comparação de um candidato entre eleições e votos por escola. Sem servidor, sem banco de dados e sem custo.
Fiz os dois com ajuda de um LLM. Este artigo mostra como o projeto é montado, de onde vêm os dados, como o mapa é desenhado e como tudo é publicado de graça. A ideia é que você consiga repetir para a sua cidade, o seu estado ou qualquer outro assunto com dados abertos.
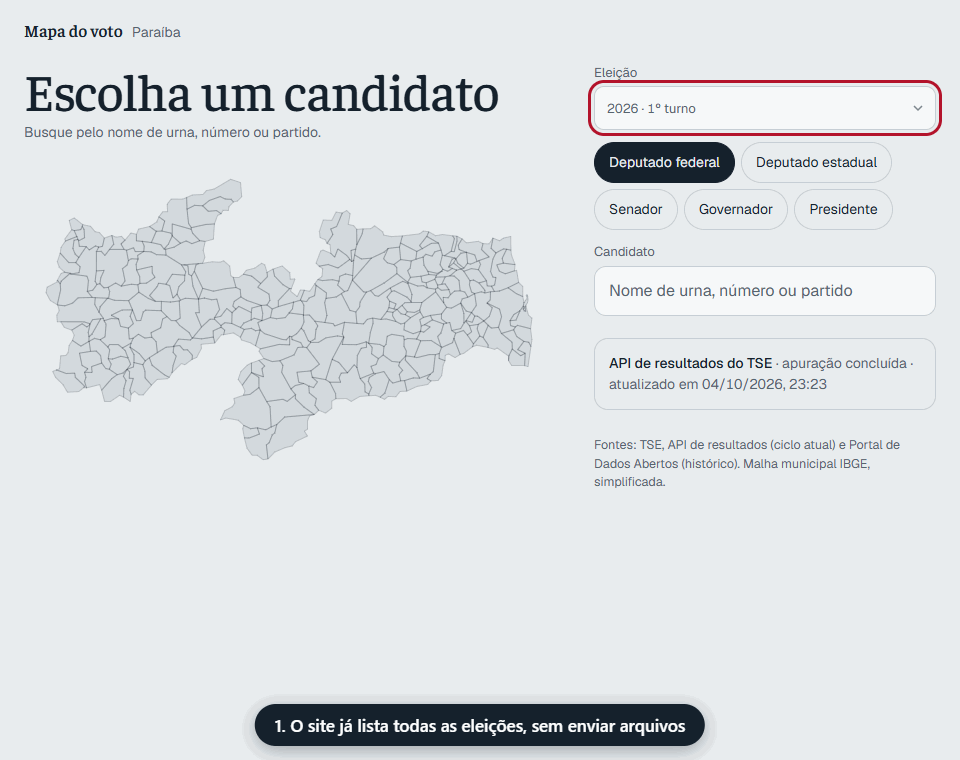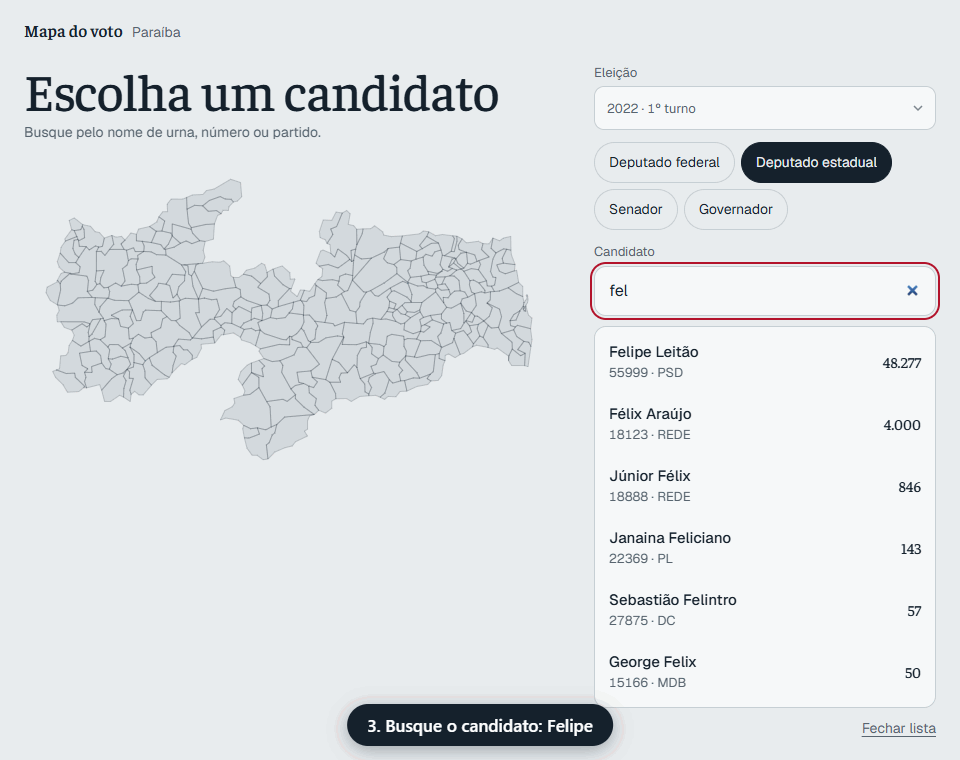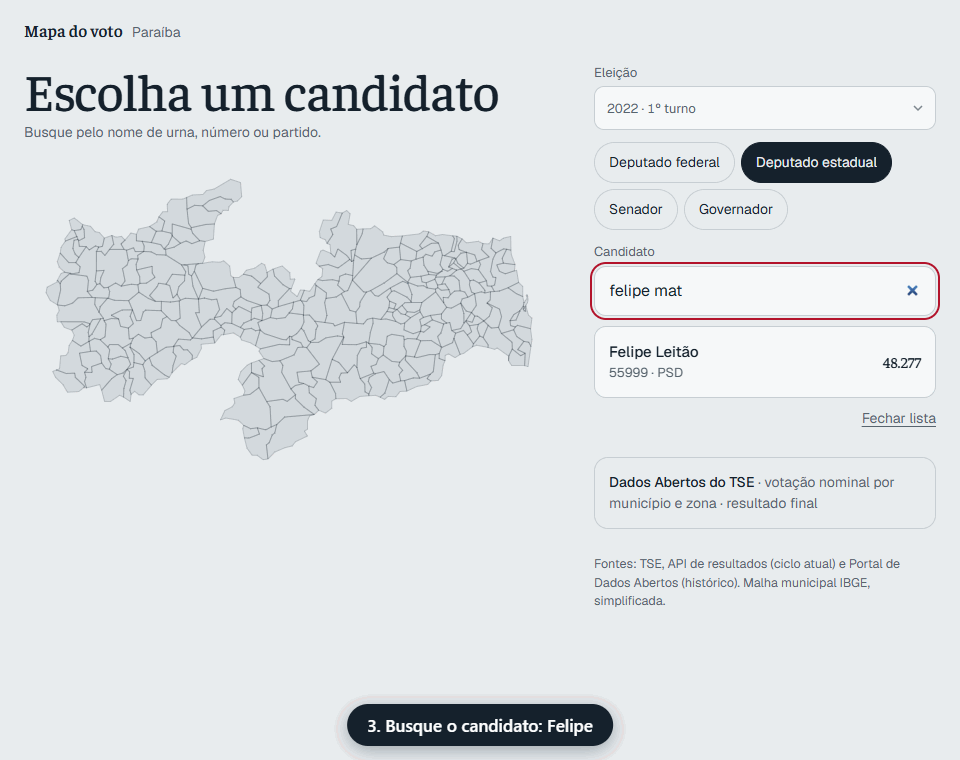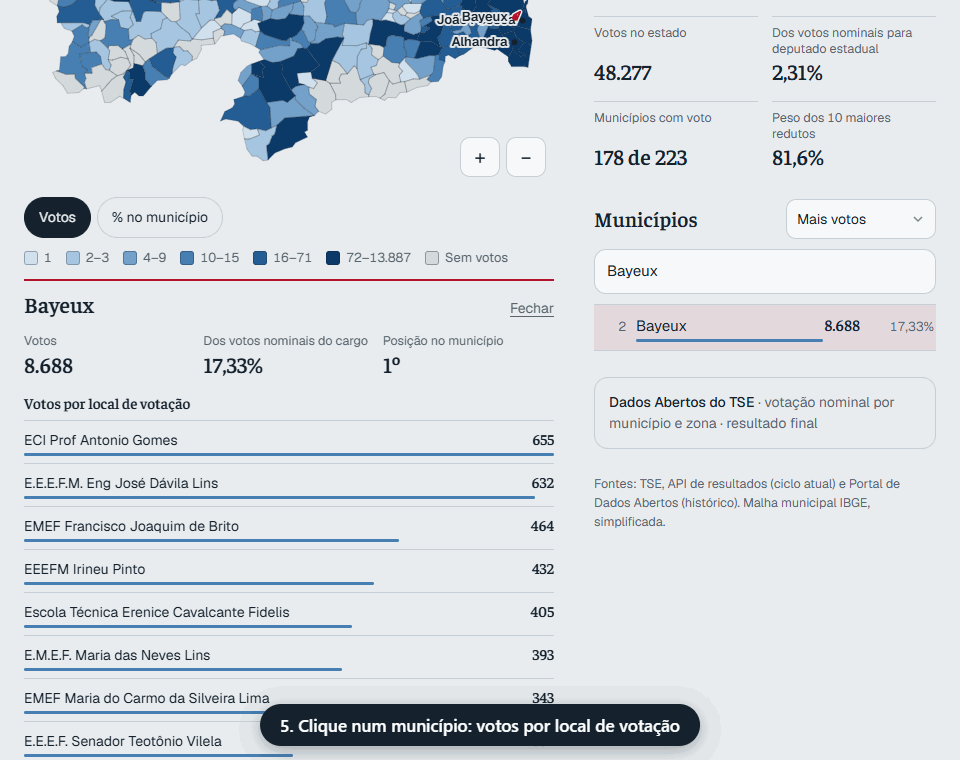
O que os sites fazem
- Paraíba: votos de presidente, governador, senador, deputado federal e deputado estadual nos 223 municípios. Ao clicar num município, aparecem os votos por escola (local de votação).
- Bayeux: votos de vereador, deputados, senador e governador por bairro, de 2012 a 2026.
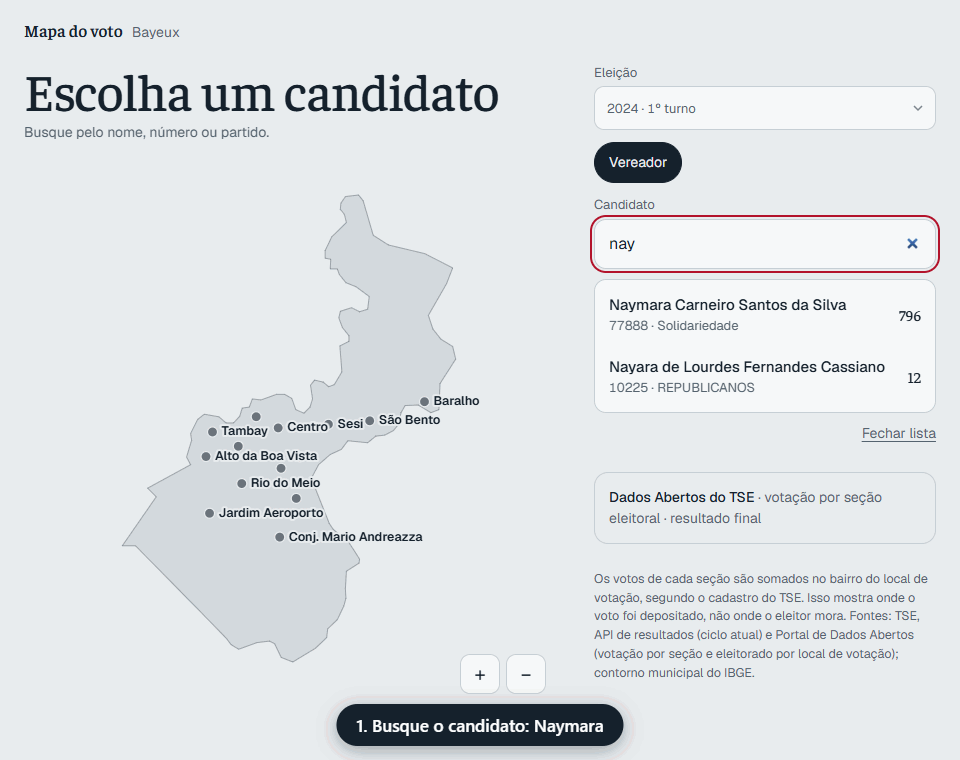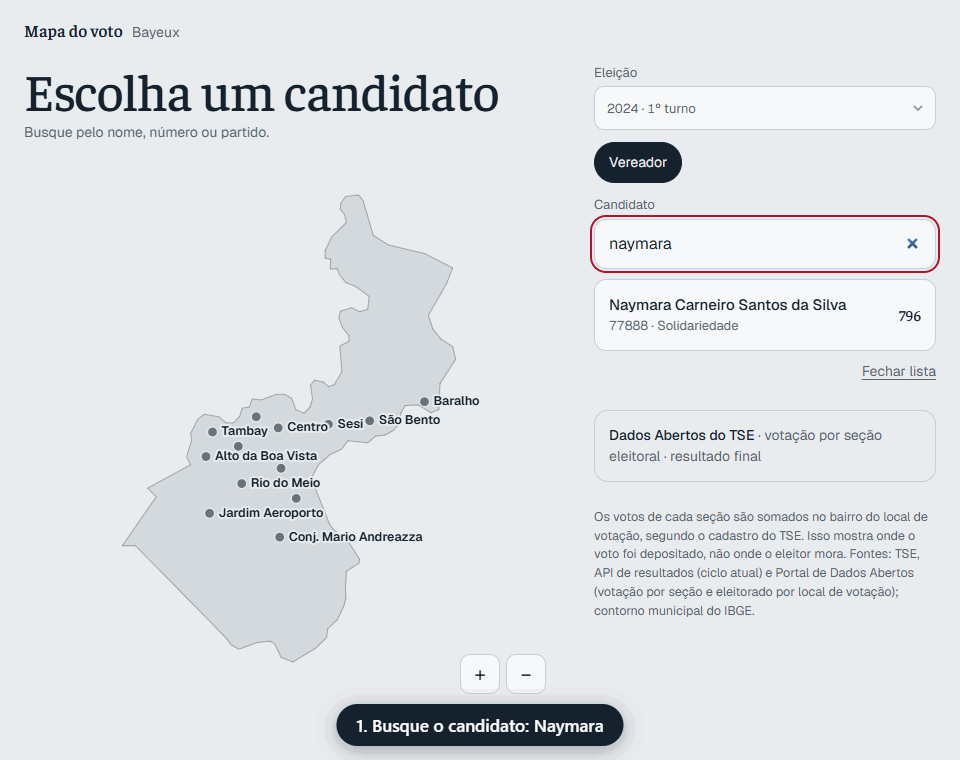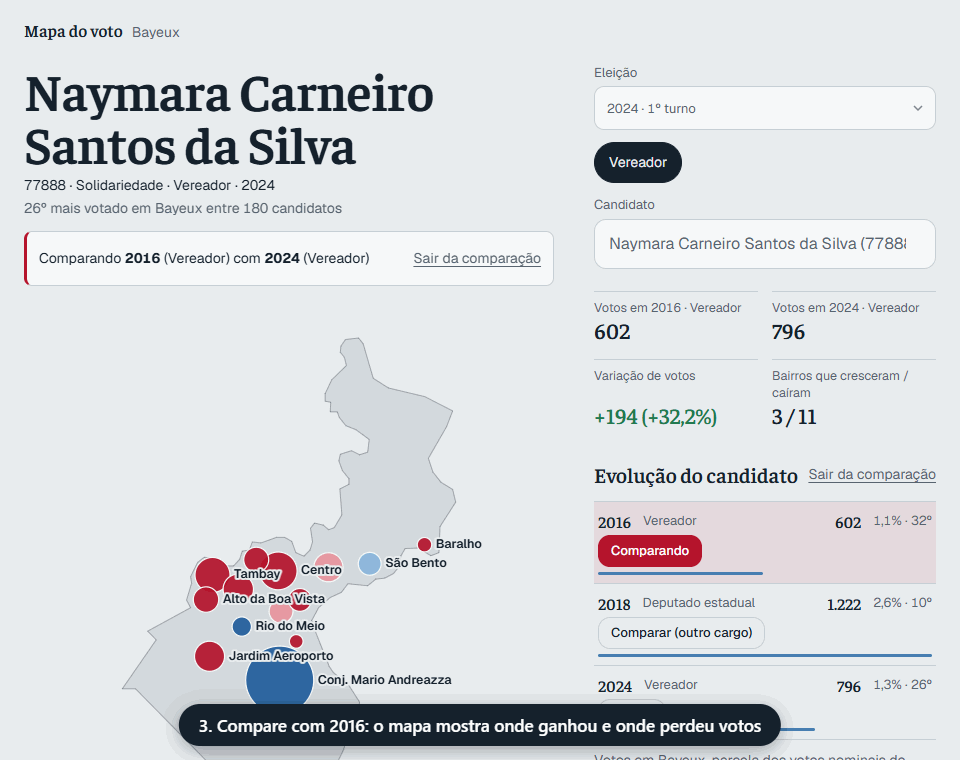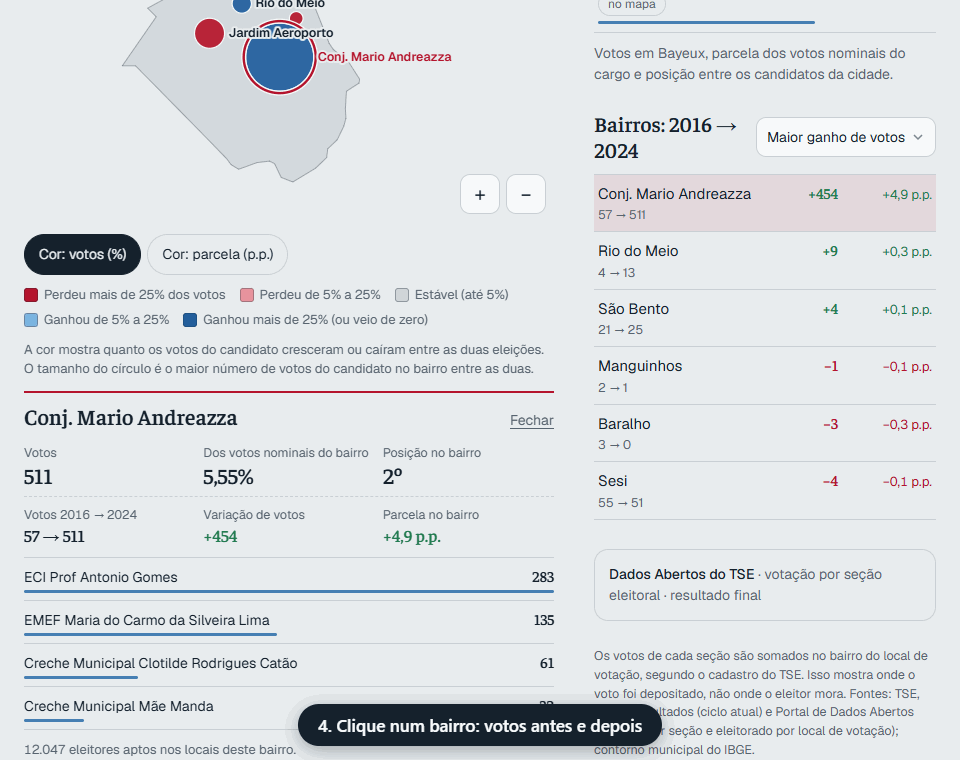
- Evolução do candidato: quando a mesma pessoa disputou mais de uma eleição, o site mostra os votos em cada uma e, no mapa, onde ela ganhou e perdeu votos.
A regra do jogo: nada que custe dinheiro
Antes de escrever código, defini restrições. Elas decidem toda a arquitetura:
| Peça | Solução | Custo |
|---|---|---|
| Fonte de dados | Portal de Dados Abertos do TSE, API de resultados do TSE, IBGE | R$ 0 |
| Banco de dados | Nenhum. Arquivos JSON commitados no repositório | R$ 0 |
| Backend | Nenhum. O site é 100% estático | R$ 0 |
| Atualização dos dados | GitHub Actions (disparo manual) | R$ 0 em repositório público |
| Hospedagem | GitHub Pages | R$ 0 |
| Bibliotecas | Preact + htm e TopoJSON via CDN, sem etapa de build | R$ 0 |
O ponto central é este: o navegador de quem visita nunca chama o TSE. Os dados são gerados uma vez, viram arquivos, e o site só lê arquivos. Isso elimina servidor, limite de requisições e dependência de uma API que pode cair no dia da eleição.
Passo 1: de onde vêm os dados
Os resultados eleitorais são públicos, mas espalhados. O gerador (scripts/gerar-dados.mjs) combina três fontes, nesta ordem de preferência:
- CSV dos Dados Abertos do TSE, com a votação nominal por município e zona. O presidente vem do arquivo nacional do mesmo .zip.
- API de resultados do TSE, só para o que o CSV ainda não tem, como um segundo turno recém-apurado. A API guarda apenas o ciclo atual e o anterior, então ela não serve como fonte do histórico.
- CSV por seção eleitoral, para o detalhe por local de votação.
Cada eleição vira um arquivo ANO-tTURNO.json em public/data/eleicoes/. Um index.json lista o que existe, e o site monta o menu de eleições a partir dele. Para ligar o mesmo candidato entre eleições, o gerador cria um pessoas.json usando o nome completo registrado no TSE.
Os arquivos por eleição ficam entre 1 e 2 MB. O detalhe por escola fica em arquivos separados (ANO-tTURNO-locais.json) que só são baixados quando o visitante clica num município. Assim a página inicial carrega rápido.
Passo 2: coletar sem derrubar o servidor dos outros
Baixar dados públicos de um órgão do governo pede educação. O módulo scripts/lib/tse.mjs tem três cuidados simples:
// poucas requisições em paralelo
export async function paralelo(itens, limite, fn) { /* ... */ }

// retentativa com espera crescente em erro de rede, 429 e 5xx
export async function getJson(url, { tentativas = 4, esperaMs = 1500 } = {}) { /* ... */ }

// arquivo grande vai para o disco e é reaproveitado nas próximas execuções
export async function baixar(url, destino) { /* ... */ }
O gerador também se identifica com um User-Agent próprio. Os .zip do TSE são lidos em streaming, linha a linha, com a biblioteca fflate, sem carregar tudo na memória. Os CSVs vêm em Windows-1252 com campos entre aspas e separados por ponto e vírgula, então o parser é feito à mão e sabe lidar com as aspas.
Passo 3: a geometria do mapa
Paraíba. O contorno dos 223 municípios vem de um GeoJSON do IBGE (repositório geodata-br). Um script (gerar-malha.mjs) renomeia municípios cuja denominação mudou desde a malha de 2010 e passa tudo pelo mapshaper, que simplifica a geometria em 12% e exporta TopoJSON. O resultado é um arquivo pequeno, suficiente para desenhar o estado inteiro no navegador.
execFileSync('npx', ['mapshaper', 'tmp/pb.geojson',
  '-simplify', '12%', 'keep-shapes',
  '-rename-layers', 'municipios',
  '-o', 'format=topojson', 'quantization=1e5', 'public/data/pb.topo.json']);
Bayeux e a pergunta dos bairros. Aqui apareceu o problema mais interessante: o TSE não publica votos por bairro. O que existe é:
- o voto por seção eleitoral;
- uma tabela “Eleitorado por local de votação”, que diz, para cada seção, em qual escola ela funciona, em que bairro (
NM_BAIRRO) e com quais coordenadas.
Juntando as duas, cada seção soma seus votos no bairro do local onde funciona. O site desenha um círculo por bairro, no centro dos locais de votação dele, com o tamanho proporcional aos votos do candidato. Por cima vai o contorno do município, vindo da API de malhas do IBGE.
Isso tem uma consequência que o site avisa e que vale repetir aqui: o mapa mostra onde o voto foi depositado, não onde o eleitor mora. É uma boa aproximação para comparar regiões da cidade, mas não é o endereço do eleitor.
Passo 4: o front-end sem build
A pasta public/ é o site. Não há Node em produção, nem webpack, nem etapa de build. O index.html carrega duas bibliotecas por CDN:
<script src="https://cdn.jsdelivr.net/npm/htm@3.1.1/preact/standalone.umd.js"></script>
<script src="https://cdn.jsdelivr.net/npm/topojson-client@3.1.0/dist/topojson-client.min.js"></script>
<script src="js/app.js"></script>
O mapa é desenhado num <canvas> 2D. Para saber em qual município o visitante clicou, o código guarda o Path2D de cada um e testa o ponto com isPointInPath. Isso funciona bem para 223 polígonos e permite zoom e arrasto sem biblioteca de mapas.
Preact com htm dá a ergonomia de componentes sem JSX e sem compilar nada. Para um projeto desse tamanho (cerca de 600 linhas de JavaScript no app inteiro), é suficiente.
Passo 5: publicar de graça
A publicação é um workflow de poucas linhas que envia a pasta public/ para o GitHub Pages a cada push na main:
- uses: actions/upload-pages-artifact@v3
  with:
    path: public
- uses: actions/deploy-pages@v4
Para as próximas eleições há um segundo workflow, de disparo manual: em Actions → Atualizar dados de uma eleição → Run workflow, informa-se o ano. Ele roda o gerador, commita os JSON novos e dispara a publicação. Em repositório público, o GitHub Actions e o Pages não cobram nada. O Pages tem limites (1 GB por site e uso moderado de banda), que um projeto como este, com cerca de 13 MB de dados, não chega perto de tocar.
Como a IA entrou nisso
A ideia veio da minha época de estágio no Tribunal de Contas da União. Lá eu trabalhei com R, Python e banco de dados, tratando bases de dados abertos e transformando em gráficos e mapas para análises, inclusive com dados abertos da Paraíba. Fiz isso em R Markdown: um arquivo para tratar os dados, outro para os gráficos e outro para um mapa por município.
Anos depois, a pergunta foi outra: quão prático e rápido seria repetir esse tipo de trabalho hoje, com um LLM ao lado? O exercício que escolhi foi o das eleições. Eu queria ler os dados do TSE e montar mapas para ver como cada município do meu estado votou, analisar a votação de cada candidato e acompanhar a evolução dele entre uma eleição e outra: onde ganhou votos, onde perdeu. É a mesma lógica das análises que eu fazia no TCU, só que agora publicada num site que qualquer pessoa abre.
O que mudou foi a forma de trabalhar. Em vez de escrever tudo do zero, fui em passos pequenos e verificáveis, e o histórico de commits mostra a ordem:
- um gerador que baixa e agrega os dados de um ano;
- o mesmo gerador para vários anos;
- o site lendo os arquivos gerados;
- a lista de eleições montada sozinha, sem enviar arquivo;
- votos por escola;
- comparação entre eleições.
A IA escreve rápido a parte mecânica: parser de CSV, leitura de .zip, componentes, workflows. O desenho e a análise continuam sendo do analista: o que perguntar aos dados, como juntar as fontes, o que o número significa. A sensação de quem já passou por R Markdown e consultas SQL é de que a parte trabalhosa deixou de ser o código e passou a ser entender os dados.
O que a IA não resolve sozinha
Quase todos os problemas reais deste projeto estão nos dados, não no código. Os que apareceram:
- Nomes de municípios mudaram depois da malha do IBGE de 2010, então foi preciso um mapa de correção (
NOMES_ATUAIS). - O CSV por seção vem com
#NULO#no nome de alguns locais em 2026, e o nome tem de ser buscado na tabela de locais. - Candidaturas anuladas deixam votos que não devem entrar na soma por local.
- O presidente não está no arquivo estadual, só no nacional.
- A API do TSE só guarda dois ciclos, então o histórico precisa ser gerado e guardado por você.
- Comparar cargos diferentes engana. Em ano de dois senadores, cada eleitor vota duas vezes, então a variação de votos não mede crescimento de apoio. O site avisa quando você compara cargos ou turnos diferentes.
Nenhum desses pontos aparece se você só aceita o primeiro código gerado. Todos aparecem quando você confere o resultado contra os números oficiais. É por isso que a regra continua sendo a mesma de sempre: LLM acelera, mas o resultado precisa ser verificável. A verificação possível aqui é comparar totais por município e por bairro com o que o próprio TSE publica.
Como repetir para a sua cidade
- Escolha o recorte (município ou estado) e ache o código do TSE e o do IBGE dele.
- Baixe um ano de votação por município e zona nos Dados Abertos do TSE e veja as colunas.
- Escreva um gerador que transforme o CSV em JSON por eleição.
- Baixe o contorno no IBGE e simplifique com
mapshaper. - Faça uma página estática que leia os JSON e desenhe o mapa.
- Publique a pasta no GitHub Pages.
Os dois repositórios estão abertos. Para uma nova cidade, o ponto de partida é o de Bayeux: troque o código do município e rode npm run dados e npm run eleicoes.
O que fica
Há alguns anos, um projeto assim exigiria servidor, banco, deploy e uma conta mensal. Hoje cabe em uma pasta de arquivos estáticos, em um repositório público e em pouco mais de um dia de trabalho com um assistente de código. Dados abertos existem, hospedagem estática é gratuita, e um LLM encurta a distância entre ter a ideia e ter o site no ar. O trabalho que sobra, e que importa, é entender os dados e conferir o resultado.
Extra: refatorando com Uncle Bob, pensando no agente
O site ficou no ar, mas o código foi escrito para ficar pronto rápido, não para durar. O gerador da Paraíba (scripts/gerar-dados.mjs) tinha 251 linhas num arquivo só, funções de 33 a 39 linhas, 22 linhas com mais de 120 caracteres e nenhum teste. Funciona, mas cada mudança dependia de rodar tudo contra o TSE e conferir na mão.
Bayeux tinha o mesmo problema em dois scripts: gerar-dados.mjs (163 linhas) e gerar-secoes.mjs (117 linhas), que ainda carregava a própria cópia do parser de CSV e do leitor de .zip.
Os princípios de Clean Code do Uncle Bob ganharam uma leitura nova com agentes de IA escrevendo boa parte do código. Usei três deles como roteiro para refatorar os dois geradores, com o próprio agente fazendo o trabalho. Cada repositório recebeu um pull request (Paraíba, Bayeux) com três commits que dá para ler na ordem: a trava, a refatoração e o CI.
1. Primeiro a trava, depois a refatoração
O ciclo de refatoração do Uncle Bob tem uma condição: só se mexe em código coberto por teste. Para código gerado por máquina isso vale ainda mais. O agente precisa conseguir rodar os testes sozinho, sem pedir nada a ninguém, para saber se a mudança dele quebrou algo.
Aqui apareceu a primeira dificuldade: a rede desta sessão não chegava ao TSE. Isso acabou sendo bom, porque obrigou o teste a ser offline desde o início. A solução foi um teste de caracterização (golden master), escrito contra o código antigo, antes de qualquer mudança:
- Um cenário pequeno de 2022, com os mesmos formatos do TSE: CSV com aspas, ponto e vírgula e Windows-1252, dentro de .zip.
- Os .zip vão para
tmp/, onde o gerador já procura antes de baixar. Nenhum download acontece. - Um
fetchfalso, carregado comnode --import, responde como a API de resultados para o 2º turno. - O script roda inteiro e a saída é gravada em
test/fixtures/esperado/.
O cenário passa de propósito pelos casos difíceis da seção anterior: presidente só no arquivo nacional, nome de local #NULO#, candidatura anulada, voto de legenda, branco, outra UF, município sem código IBGE e 2º turno vindo da API. Conferi a saída gravada à mão antes de confiar nela.
// test/fixtures/fetch-falso.mjs: URL fora do arquivo responde 404,
// que é como o TSE responde a um arquivo que ainda não existe.
globalThis.fetch = async url => {
  const corpo = respostas[String(url)];
  return corpo ? Response.json(corpo) : new Response('não encontrado', { status: 404 });
};
Em Bayeux, o cenário tem duas eleições: 2024 pelo CSV por seção e 2026 só pela API, que é o caminho de quando o TSE ainda não publicou o arquivo por seção. Ele também cobre o que é próprio dos bairros: “CENTRO” e “Centro” no mesmo bairro, coordenada com vírgula decimal, coordenada fora do município e seção que não está na tabela de locais.
Esse teste foi o primeiro commit nos dois repositórios. Só depois dele o código começou a mudar.
2. Funções e arquivos curtos como contrato de contexto
A leitura atual do “funções pequenas” é que um bloco de 10 a 20 linhas cabe inteiro na atenção do modelo. Vale ser preciso aqui: um LLM lê 251 linhas sem esforço. O ganho real está em outro lugar. Com unidades pequenas, o agente consegue ler só o que vai mudar, mudar só isso e testar só isso. A edição fica cirúrgica, o diff fica pequeno e a revisão humana fica possível.
Antes, uma função lia o .zip, filtrava a linha, convertia o código do município, somava o voto e corrigia a situação do candidato, tudo junto:
const ibge = ibgeDe(c[ix.CD_MUNICIPIO]); if (!ibge) { semMun.add(c[ix.CD_MUNICIPIO]); return; }
const turno = c[ix.NR_TURNO], tk = `${ano}|${turno}|${cargo}`, key = `${tk}|${c[ix.SQ_CANDIDATO]}`;
const ds = porTurno[turno] ||= novoDs('csv');
Depois, cada fonte de dados separa duas coisas: o tratamento de uma linha, que é uma função pura, e a leitura do arquivo, que é I/O. A primeira é testada sem .zip nenhum:
aoRegistro: (campos, colunas) => {
  if (!ehDaEleicao(campos, colunas, ano, cargoAceito)) return;
  const ibge = ibgeDe(campos[colunas.CD_MUNICIPIO]);
  if (!ibge) { semIbge.add(campos[colunas.CD_MUNICIPIO]); return; }
  const candidato = candidatoDoRegistro(campos, colunas, ano);
  const apuracao = apuracaoDoTurno(porTurno, candidato.turno, 'csv');
  somarVoto(apuracao, candidato, ibge, inteiro(campos[colunas[colunaDeVotos]]));
  // ...
},
O gerador da Paraíba virou 14 arquivos, cada um com uma responsabilidade:
| Pasta | O que tem |
|---|---|
gerar-dados.mjs |
Só a linha de comando: escolhe os anos e encadeia as etapas |
eleicao/ |
Configuração (UF, cargos), conversão TSE→IBGE e a soma de votos |
fontes/ |
Uma fonte por arquivo: CSV por município, API, CSV por seção, tabela de locais |
saida/ |
Poda dos locais, pessoas.json, index.json e escrita dos arquivos |
lib/ |
CSV do TSE e acesso à rede (retentativa, paralelismo, cache, .zip) |
O que toca a rede entra por parâmetro (buscarJson, ibgeDe), então o teste troca por uma versão falsa sem gambiarra.
Bayeux seguiu a mesma divisão e ganhou uma pasta secoes/ para a tabela de locais: a grafia dos bairros, as coordenadas e a montagem da tabela viraram funções puras. A cópia do parser de CSV sumiu, e a pasta lib/ passou a ser igual nos dois repositórios. Duplicação também é contexto: se o agente corrige um bug numa cópia, nada garante que ele vai lembrar da outra.
3. Nomes que explicam, comentários que justificam
Modelos de linguagem processam nomes como texto com significado. ds, tk, ix, c e MIN_DIG obrigam quem lê, pessoa ou modelo, a reconstruir a intenção a partir do uso. Viraram apuracao, chaveDoCargo, colunas, campos e DIGITOS_DO_CANDIDATO. Os códigos de cargo ('1', '3') ganharam nome (CARGOS.PRESIDENTE, CARGOS.GOVERNADOR), e regras soltas no meio de um if viraram funções com nome:
export function ehVotoNominal(cargo, numero) {
  const digitos = DIGITOS_DO_CANDIDATO[cargo];
  return Boolean(digitos) && numero.length >= digitos && !NUMEROS_BRANCO_E_NULO.includes(numero);
}
Os comentários que sobraram explicam o porquê, que é o que o código não consegue dizer: por que o presidente vem de outro arquivo, por que existe #NULO#, por que a poda de locais existe. Comentários que repetiam o código saíram.
Uma exceção consciente: os nomes curtos dentro dos JSON (cands, tot, mun) ficaram como estavam. Eles são o contrato com o front-end, e renomear quebraria o site sem ganho nenhum.
O que a sabotagem mostrou
Um teste que nunca falha não prova nada. Por isso, depois da refatoração, quebrei o código de propósito para ver se a trava pegava.
Na Paraíba, tirei o “95” (voto branco) da lista de números ignorados. O golden master continuou passando. O motivo: mais adiante, a poda de locais remove qualquer número que não seja de um candidato, e o erro some antes de chegar à saída. O golden master garante que o resultado final não mudou, mas não garante que cada regra funciona sozinha. Se a poda mudar um dia, esse erro aparece.
Por isso vieram os testes unitários, um por regra: divisão do CSV, voto de legenda, branco e nulo, #NULO#, poda de candidaturas anuladas, ligação de pessoas entre eleições e o que é pedido à API. Com eles, a mesma sabotagem falha na hora, com uma mensagem que diz exatamente o que quebrou:
not ok 15 - branco (95) e nulo (96) não são votos nominais
A lição vale para qualquer código gerado por IA: o golden master protege a refatoração, e o teste unitário protege a regra. Um não substitui o outro.
O agente precisa saber como se verificar
A última peça é dizer ao agente, por escrito, como ele confere o próprio trabalho. O repositório ganhou um CLAUDE.md curto:
- Rode `npm test`. Roda offline e em menos de um segundo; não há outro passo de verificação.
- Se o golden master falhar, a saída mudou: corrija o código. Só regrave quando
  a mudança na saída for o objetivo da tarefa, e diga no resumo o que mudou.
- Regra nova ou caso novo dos dados do TSE: escreva primeiro o teste, veja falhar, depois o código.
E o CI passou a rodar npm test em todo push e pull request, e também antes do workflow que gera os dados de uma eleição nova. Se o gerador estiver quebrado, os dados errados não chegam a ser publicados.
Antes e depois
| Paraíba antes | Paraíba depois | Bayeux antes | Bayeux depois | |
|---|---|---|---|---|
| Arquivos dos geradores | 2 | 14 | 3 | 17 |
| Maior arquivo | 251 linhas | 96 linhas | 163 linhas | 93 linhas |
| Maior função | 39 linhas | 16 linhas | 38 linhas | 20 linhas |
| Funções com mais de 20 linhas | 4 | 0 | 4 | 0 |
| Linhas com mais de 120 caracteres | 22 | 0 | 27 | 0 |
| Testes | 0 | 31 | 0 | 31 |
| Saída gerada | idêntica | idêntica |
Os testes rodam offline e levam menos de meio segundo em cada repositório. O código ficou maior: na Paraíba, de 357 para 625 linhas; em Bayeux, de 386 para 602. É o preço de nomes mais longos, funções separadas e regras explícitas, e é um preço que vale. A conferência final foi com os dados reais: rodando o gerador de índice sobre os dados já publicados, index.json e pessoas.json saíram idênticos aos que estão no ar nos dois sites.
O resumo é o mesmo do resto do artigo, agora aplicado ao código: o LLM acelera, mas o resultado precisa ser verificável. Na primeira versão, quem verificava era eu, comparando números com o TSE. Agora o próprio agente verifica, em meio segundo, toda vez que mexe em algo.